
Inleiding
Big Data beschrijft de enorme hoeveelheden informatie die wereldwijd door organisaties worden gegenereerd en verzameld — van zoekmachines en sociale platforms tot bedrijfssystemen. Het verzamelen van deze gegevens is kostbaar en complex, maar de echte uitdaging ligt in het analyseren ervan om bedrijfswaarde te extraheren.
De uitdaging van Big Data
- Schaal: Miljarden records, multimediabestanden en logs die dagelijks worden gegenereerd.
- Infrastructuur: Vereist 24/7 datacenters met geavanceerde hardware en software.
- Kosten: Bedrijven moeten de uitgaven rechtvaardigen door data om te zetten in bruikbare inzichten.
Apache Hive: Een Data Warehouse voor Big Data
Apache Hive is open-source datawarehouse-software die:
- Het bevragen en beheren van grote datasets in gedistribueerde opslag vergemakkelijkt
- Draait bovenop Apache Hadoop, wat gedistribueerde verwerking over clusters mogelijk maakt
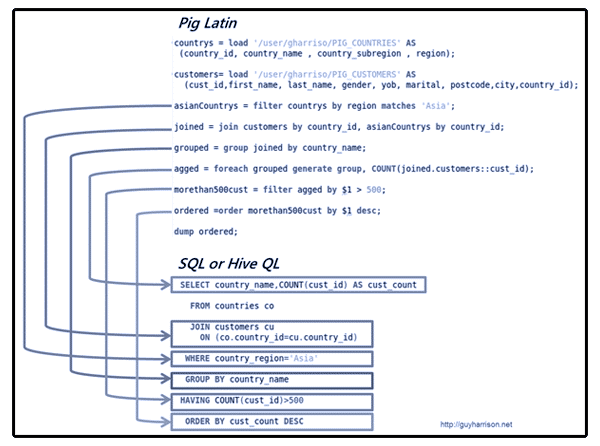
- Gebruikmaakt van HiveQL, een SQL-achtige taal, om query’s toegankelijk te maken voor analisten
Hoe Hive samenwerkt met Hadoop
- HDFS (Hadoop Distributed File System): Slaat enorme datasets op over clusters.
- MapReduce: Verwerkt datasets van meerdere terabytes parallel.
- Apache Pig: Biedt een platform op een hoger niveau voor het produceren van MapReduce-programma’s.
- HBase-compatibiliteit: Hive kan ook gegevens bevragen die zijn opgeslagen in HBase en andere systemen.
Samen stellen deze tools organisaties in staat om data op schaal te extraheren, transformeren en analyseren.
Waarom Hive belangrijk is voor bedrijven
- Schaalbaarheid: Begin met een paar servers en schaal op naar duizenden.
- Fouttolerantie: Hadoop detecteert en herstelt fouten op de applicatielaag.
- Toegankelijkheid: SQL-achtige query’s maken Big Data-analyse eenvoudiger voor niet-ontwikkelaars.
- Waarde-extractie: Verandert ruwe data in inzichten die de besluitvorming sturen.
Overwegingen bij implementatie
Het inzetten van Hive en Hadoop vereist:
- Robuuste IT-infrastructuur (rekenkracht, opslag en netwerken)
- Geschoolde professionals om clusters te configureren en te onderhouden
- Zorgvuldige planning om analytics af te stemmen op bedrijfsdoelen
Conclusie
Apache Hive maakt, samen met Hadoop en gerelateerde tools, Big Data-analyse praktisch en krachtig. Met de juiste infrastructuur en expertise kunnen organisaties enorme datasets transformeren in betekenisvolle inzichten die groei en innovatie ondersteunen.